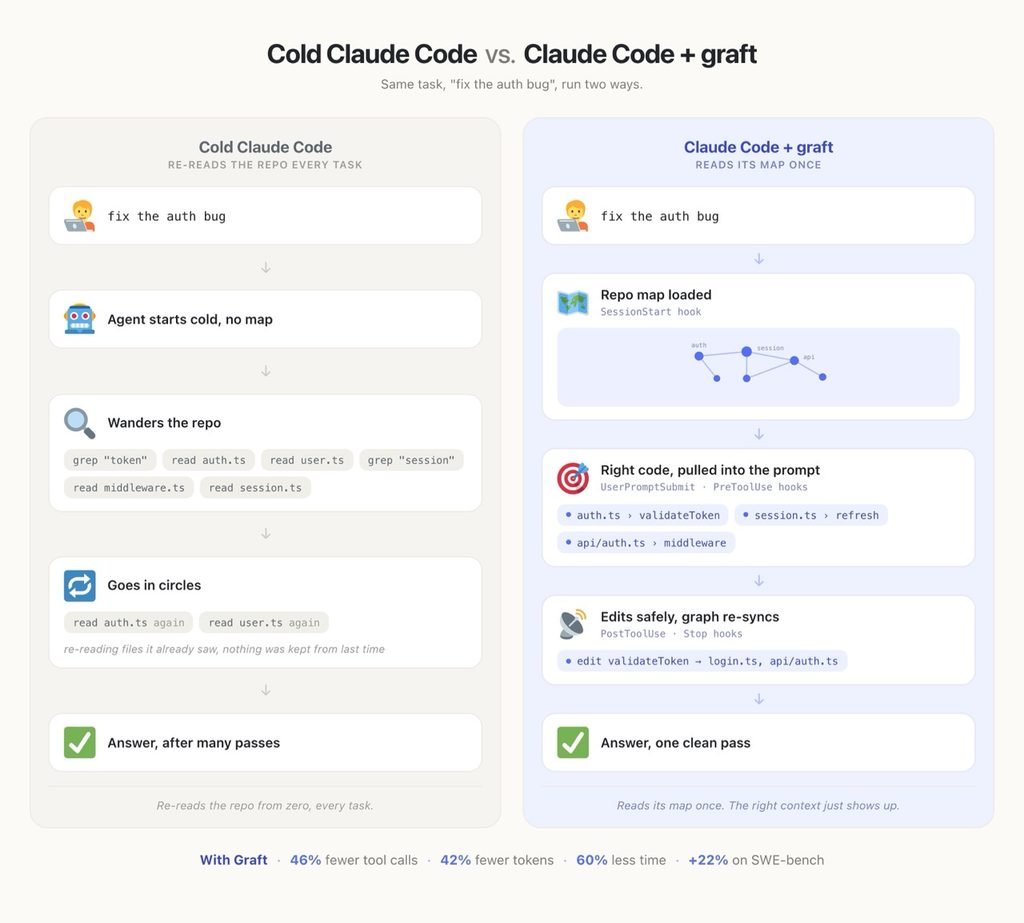
Bạn giao cho Claude Code sửa một lỗi đăng nhập. Việc đầu tiên nó làm không phải sửa, mà là đi tìm: tìm từ khóa, mở file, lần theo từng dòng nhập, thấy sai hướng thì lùi lại tìm tiếp. Phiên sau, nó lại làm đúng như vậy với cùng dự án đó. Phần lớn lượt gọi công cụ, token và thời gian của mỗi phiên làm việc đổ vào chuyện khám phá lại những thứ nó đã biết từ hôm qua.
Graft là công cụ mã nguồn mở nhắm thẳng vào chỗ lãng phí này. Bài này giới thiệu nó làm gì, cách cài, cách dùng, và cả những chỗ bạn nên đọc kỹ trước khi tin vào các con số quảng cáo.
Graft làm gì?
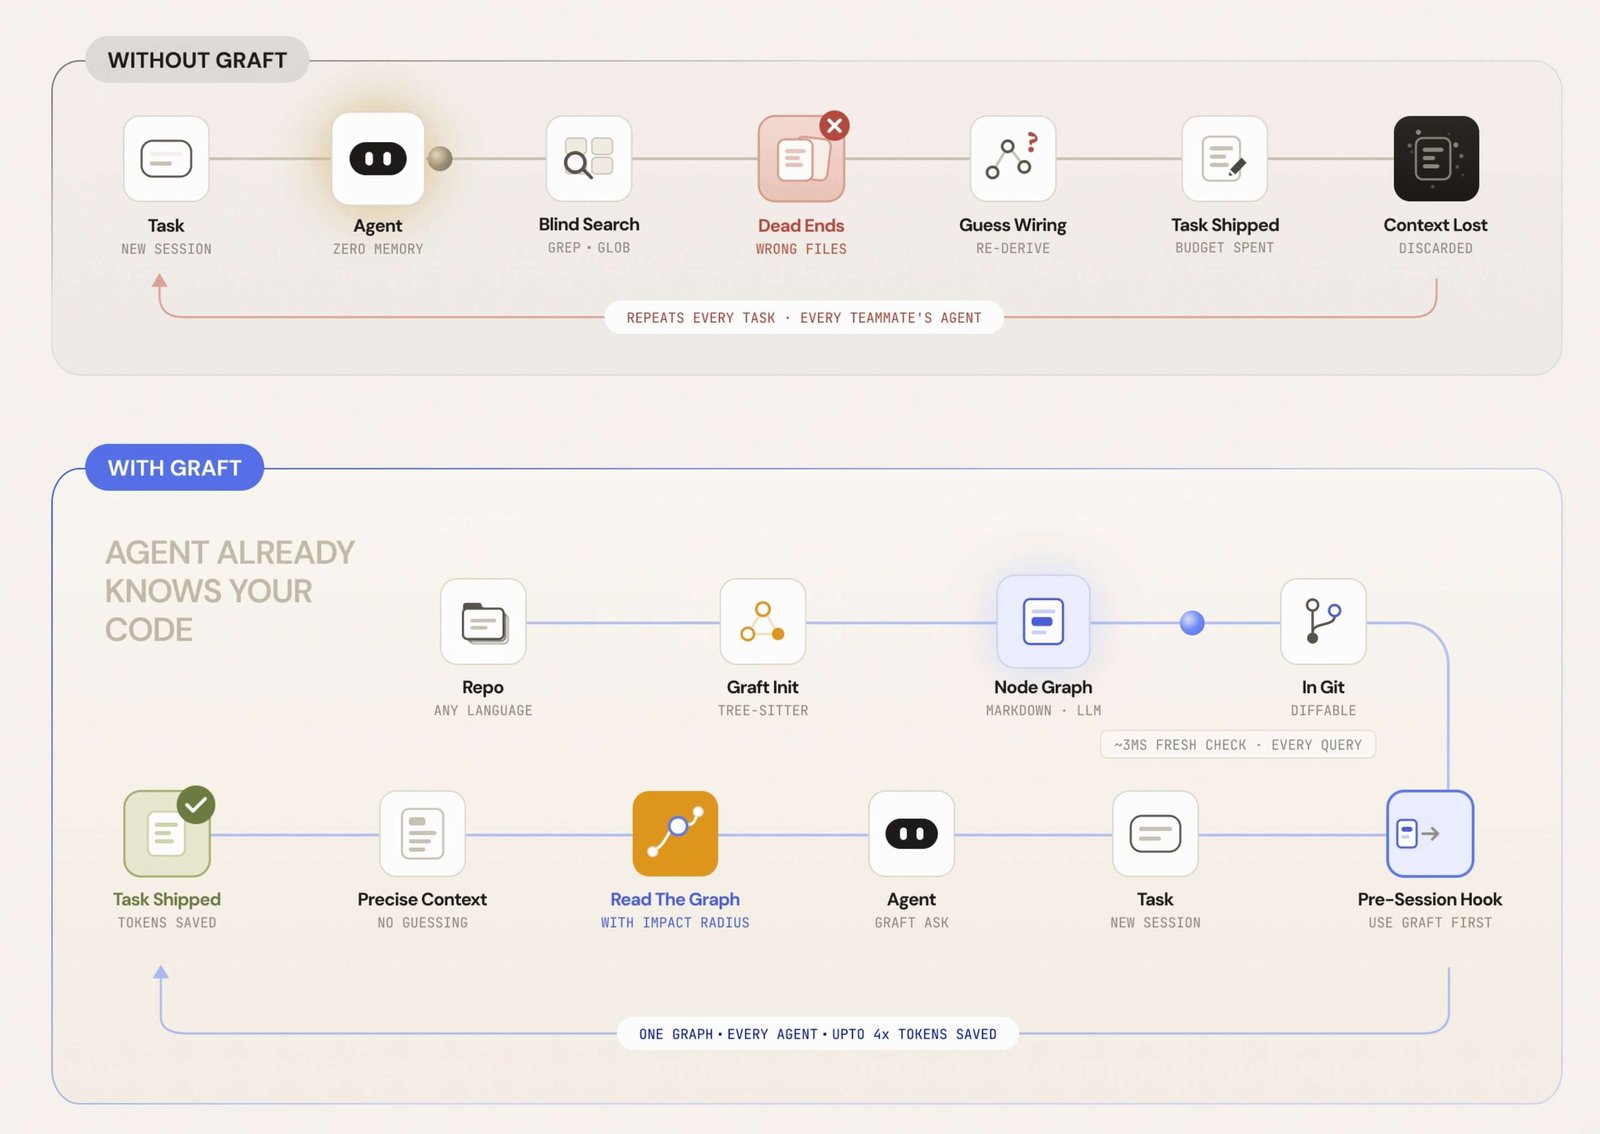
Ý tưởng khá đơn giản: thay vì để trợ lý AI tự lần mò mỗi lần, Graft đọc dự án của bạn một lần rồi ghi lại hiểu biết đó thành một thư mục graft/ gồm các file markdown liên kết với nhau. Mỗi file là một “nút”, đại diện cho một hệ thống con, một API hay một khái niệm trong code, kèm phần giải thích bằng tiếng thường: phần này làm gì, nối với phần nào khác. Trợ lý AI mở những file này giống hệt cách nó mở mọi file khác trong dự án. Không có cơ sở dữ liệu, không có máy chủ, không có chỉ mục tìm kiếm theo vector.
Có hai tầng cần phân biệt, vì nó ảnh hưởng đến chuyện bạn có phải đưa khóa API hay không. Tầng cấu trúc (mỗi hàm, mỗi lớp, ai gọi ai) được dựng bằng tree-sitter, chạy hoàn toàn trên máy bạn, không gọi mô hình AI nào, không cần khóa. Tầng giải thích bằng lời (tóm tắt từng file, gom thành nút khái niệm) mới cần một mô hình ngôn ngữ, và bạn tự chọn nhà cung cấp: OpenAI, Anthropic, OpenRouter, Groq, mô hình chạy cục bộ… bằng khóa của chính bạn.
Một điểm hay là đồ thị luôn được làm mới theo code hiện tại. Mỗi lần truy vấn, Graft kiểm tra nhanh xem cây thư mục có thay đổi không (khoảng 3 mili giây nếu không đổi) và dựng lại phần cấu trúc nếu cần, kể cả những chỉnh sửa bạn chưa commit. Bạn không phải nhớ chạy lại gì cả.
Về ngôn ngữ, Graft hỗ trợ 23 ngôn ngữ. Nhóm được xử lý kỹ nhất gồm TypeScript/JavaScript, Python, Go, Java, Kotlin, PHP, Swift và R. Nhóm còn lại như Rust, C/C++, C#, Ruby… được hỗ trợ ở mức rộng hơn nhưng bớt tinh hơn. File thuộc ngôn ngữ không có trong danh sách sẽ bị bỏ qua.
Cài đặt Graft thế nào?
Bạn cần Node.js phiên bản 20 trở lên. Gói trên npm là @nanonets/graft, giấy phép MIT, và phiên bản mới nhất lúc mình viết bài là 0.21.1, tức vẫn chưa lên 1.0, nên hãy chuẩn bị tinh thần là mọi thứ còn đổi nhanh.
npm install -g @nanonets/graft
Không muốn cài toàn cục thì chạy thẳng bằng npx @nanonets/graft init, kết quả như nhau. Sau đó, đứng trong thư mục dự án và chạy:
graft initLệnh này hỏi bạn muốn nối Graft vào những trợ lý nào (Claude Code được chọn sẵn), dựng đồ thị từ code của bạn, rồi cài thêm thanh trạng thái và các hook vào thư mục .claude/. Từ phiên làm việc kế tiếp, Graft tự đi cùng Claude Code: mỗi lời nhắc được gắn thêm các nút liên quan, và sau mỗi lượt làm việc đồ thị được dựng lại ngầm.
Mẹo nhỏ: Hãy chạy
graft init --dry-runtrước. Nó liệt kê toàn bộ file sẽ bị đụng tới mà chưa ghi gì cả. Muốn bỏ qua bước hỏi và chỉ nối Claude Code, dùnggraft init --agents claude.
Với Cursor, Codex, Gemini, Copilot, Windsurf, Kiro và vài trợ lý khác, init ghi file hướng dẫn riêng của từng công cụ (như AGENTS.md, GEMINI.md, .cursor/rules/graft.mdc). Riêng Claude Code, nó ghi một file skill riêng và không động đến CLAUDE.md của bạn.
Có một chỗ dễ bất ngờ: nếu máy bạn có thư mục ~/.codex/, chọn nhóm agents sẽ ghi cả vào cấu hình Codex ở cấp người dùng, tức áp dụng cho mọi dự án, không riêng dự án này. Không muốn vậy thì thêm --no-global.
Về chuyện chia sẻ với đồng đội: thư mục graft/ được tự thêm vào .gitignore vì nó là bộ nhớ đệm có thể dựng lại, giống node_modules. Thứ bạn commit là phần nối dây trong .claude/, còn mỗi người tự chạy graft build để có đồ thị của mình.
git add .claude && git commit -m "nối graft vào dự án"
Dùng Graft hằng ngày
Với Claude Code, phần lớn thời gian bạn không phải làm gì thêm. Nhưng các lệnh dòng lệnh cũng rất đáng thử, vì chúng cho bạn thấy trợ lý AI đang “nhìn” dự án ra sao.
Lệnh graft map cho cái nhìn đầu tiên về một dự án lạ: các cụm thư mục, những hàm được gọi nhiều nhất, những điểm nóng. Lệnh graft ask "đăng nhập kiểm tra mật khẩu ở đâu" trả về các nút xếp theo độ liên quan, kèm đúng file và số dòng, không gọi mô hình AI. Khi cần xem một file mà không muốn đọc cả thân hàm, graft skeleton đường-dẫn-file chỉ liệt kê chữ ký các hàm, theo README thì tốn khoảng một phần mười số token.
Hai lệnh sau đặc biệt hữu ích trước khi sửa code. graft callers tên-hàm cho biết ai đang gọi hàm đó, thêm -d 3 để đi sâu ba tầng và thấy toàn bộ phạm vi ảnh hưởng. Còn graft grep "regex" tìm kiếm khắp dự án nhưng gom kết quả theo hàm chứa nó, xếp hàm nào được nhiều nơi gọi lên trước. Nếu bạn làm việc theo nhóm, graft blast --base origin/main chỉ ra những phần code bị ảnh hưởng bởi một thay đổi, dùng được trong bước kiểm tra pull request.
Muốn xem tận mắt, chạy graft viz: nó mở một trang tương tác ngay trên máy với đồ thị khái niệm, đồ thị từng hàm và cây thư mục. Chọn một nút, các cạnh sẽ đổi màu theo chiều phụ thuộc (hổ phách là nó phụ thuộc vào gì, xanh ngọc là cái gì phụ thuộc vào nó).
Muốn có phần giải thích bằng lời, bạn chạy graft build --deep kèm khóa API. Cấu hình qua biến môi trường GRAFT_PROVIDER, GRAFT_API_KEY, GRAFT_MODEL, và GRAFT_BASE_URL nếu dùng điểm cuối tương thích OpenAI. Chạy lại chỉ xử lý những file đã đổi, nên lần sau rẻ hơn nhiều. Và chế độ tự đồng bộ sẽ không bao giờ tự gọi mô hình thay bạn, nên không lo tốn tiền ngoài ý muốn.
Nếu trợ lý của bạn hỗ trợ MCP, Graft còn đăng ký sẵn sáu công cụ như graft_find_code, graft_file_api, graft_trace_calls. Với Claude Code, init ghi vào .mcp.json của dự án; nhớ khởi động lại Claude Code để nó nhận. Muốn gỡ sạch mọi thứ, graft uninstall (thêm -y để thực sự xóa).
Con số quảng cáo: đọc sao cho tỉnh táo
README nêu rất to dòng “rẻ hơn tới 4 lần, nhanh hơn tới 3 lần”. Đọc kỹ các bảng bên dưới thì bức tranh khiêm tốn hơn, dù vẫn đáng chú ý. Trong thử nghiệm 162 lượt chạy trên hai dự án, chi phí giảm 32%, token giảm 42%, số lượt gọi công cụ giảm 46%, thời gian giảm 60%, còn độ đúng ngang nhau (93%). Trên PocketBase, chi phí giảm 21% và thời gian giảm 14%. Bản thân mình không tìm được bảng nào trong README cho ra con số “4 lần”, nên hãy hiểu “tới 4 lần” là trường hợp tốt nhất, không phải mức bạn sẽ gặp thường xuyên.
Chuyện độ đúng cũng cần đặt đúng cỡ. Trên SWE-bench Verified, Graft giải được 33 trên 50 bài so với 27 trên 50 khi không dùng, tức hơn 6 bài. Đó là tín hiệu tốt, nhưng mẫu 50 bài là nhỏ, và toàn bộ số liệu đều do chính nhóm làm công cụ tự đo. Mình xem đây là lý do để thử trên dự án của bạn, không phải bằng chứng đã chốt.
Quyền riêng tư: Graft có gửi dữ liệu không?
Có, một ít, và README nói rõ chuyện này. Ngoài các yêu cầu tới nhà cung cấp mô hình mà bạn tự cấu hình, Graft kiểm tra phiên bản npm mỗi ngày một lần và gửi một gói thống kê ẩn danh. Gói này chỉ chứa nhãn cố định và số liệu theo khoảng, không có code, đường dẫn, tên kho, tên hàm hay nội dung truy vấn. Bạn xem đúng thứ máy mình sẽ gửi bằng graft telemetry debug, và tắt bằng graft telemetry disable hoặc đặt DO_NOT_TRACK=1. Nó tự tắt trong môi trường CI.
Có nên thử Graft không?
Nếu bạn hay giao việc cho trợ lý AI trên những dự án vừa và lớn, nhất là khi nhiều người cùng làm, Graft đáng một buổi chiều để thử: cài mất hai lệnh, gỡ cũng một lệnh, và bạn tự đo được nó có tiết kiệm thật trên code của mình không. Với dự án nhỏ vài chục file, lợi ích có lẽ không nhiều vì trợ lý AI vốn đã tìm được thứ cần tìm khá nhanh.
Bạn đã thử Graft hay công cụ nào tương tự chưa? Kể kết quả bên dưới nhé, mình rất muốn biết con số thật trên dự án của bạn.
Để lại một bình luận