Nếu bạn từng sử dụng ElevenLabs, MiniMax Audio hay các công cụ AI để tạo giọng đọc cho video, podcast hoặc sách nói, thì VibeVoice là một dự án rất đáng để khám phá.
Được phát triển bởi Microsoft, VibeVoice là bộ mô hình AI giọng nói mã nguồn mở, có khả năng chuyển văn bản thành giọng nói (Text-to-Speech) và nhận diện lời nói thành văn bản (Speech-to-Text). Điểm thú vị là VibeVoice không chỉ xử lý những đoạn hội thoại ngắn mà còn được thiết kế cho nội dung dài, nhiều người nói và có ngữ cảnh phức tạp.
Với những ai thường xuyên làm video YouTube, TikTok, podcast hoặc cần xử lý bản ghi âm cuộc họp, VibeVoice mở ra khá nhiều khả năng thú vị mà không nhất thiết phải phụ thuộc hoàn toàn vào các dịch vụ AI trả phí.
VibeVoice có gì nổi bật?
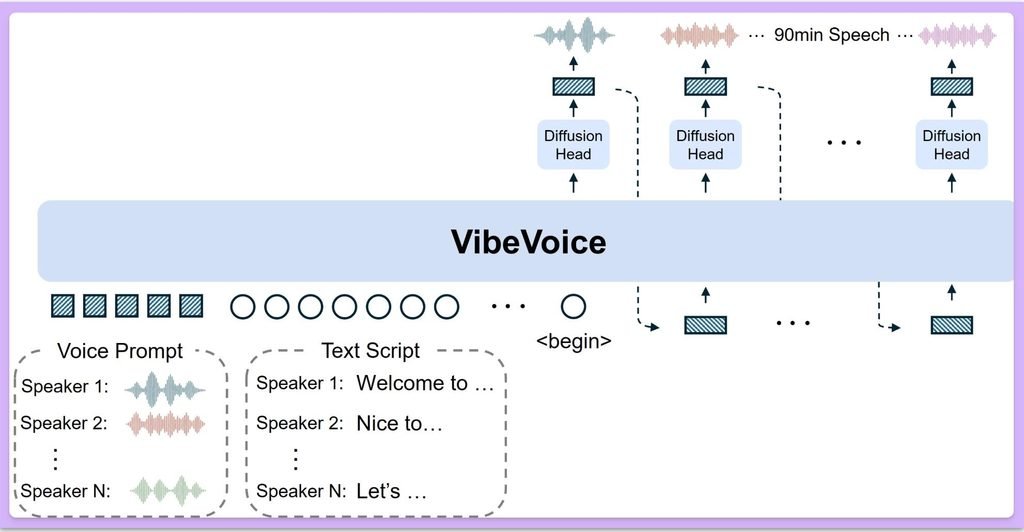
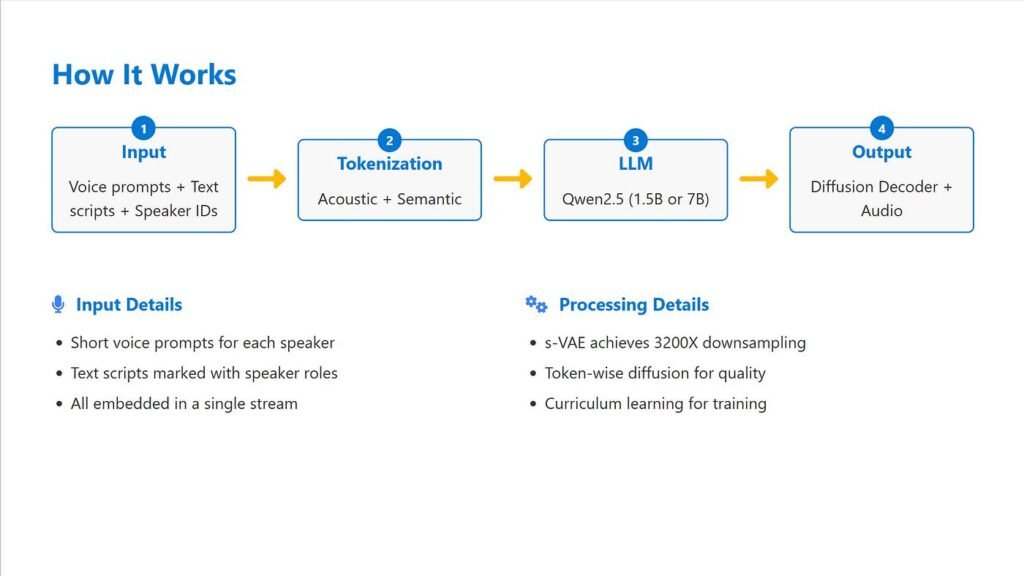
Điểm khác biệt của VibeVoice nằm ở cách xử lý giọng nói theo ngữ cảnh dài. Thay vì chỉ tập trung đọc từng câu riêng lẻ, các mô hình trong dự án được phát triển để hiểu mạch hội thoại, nhận biết người nói và duy trì sự nhất quán xuyên suốt nội dung.
Tạo giọng nói dài với nhiều nhân vật
VibeVoice-TTS được giới thiệu với khả năng tạo âm thanh dài đến 90 phút trong một lần xử lý, hỗ trợ tối đa 4 người nói. Điều này đặc biệt thú vị khi xây dựng podcast, truyện kể hoặc những đoạn hội thoại giữa nhiều nhân vật.
Mô hình cũng hướng đến khả năng thể hiện cảm xúc và ngữ điệu tự nhiên hơn, giúp nội dung không đơn thuần giống một giọng máy đang đọc văn bản. Tuy nhiên, mã nguồn TTS ban đầu đã được Microsoft gỡ khỏi repository từ tháng 9/2025 do lo ngại về việc sử dụng sai mục đích. Vì vậy, không nên nhầm khả năng được giới thiệu trong nghiên cứu với tính năng hiện có thể cài đặt trực tiếp. GitHub
Chuyển âm thanh thành văn bản thông minh
VibeVoice-ASR có thể xử lý bản ghi âm dài đến 60 phút trong một lần, đồng thời xác định ai đang nói, nói vào thời điểm nào và nội dung là gì.
Ví dụ, khi đưa một bản ghi cuộc họp vào hệ thống, thay vì nhận về một đoạn văn bản dài khó theo dõi, bạn có thể nhận được transcript có phân biệt người nói và mốc thời gian. Đây là tính năng hữu ích cho việc tạo phụ đề, tóm tắt cuộc họp hoặc biên tập podcast.
Nhận diện giọng nói theo thời gian thực
VibeVoice-ASR-Streaming cho phép chuyển lời nói thành văn bản ngay khi âm thanh đang được truyền vào, không cần đợi ghi âm hoàn tất. Phiên bản này hỗ trợ 10 ngôn ngữ và có thể bổ sung các từ khóa chuyên biệt để cải thiện khả năng nhận diện.
Có phiên bản nhẹ chạy bằng CPU
Một điểm đáng chú ý khác là VibeVoice-ASR-BitNet. Microsoft đã tối ưu mô hình nhận diện giọng nói từ khoảng 4,62 GB xuống còn 1,58 GB, hướng đến khả năng chạy trên CPU mà không bắt buộc phải có GPU riêng.
Đây là hướng đi khá thú vị cho những ai muốn triển khai AI giọng nói trên máy cá nhân hoặc thiết bị có tài nguyên hạn chế. GitHub
Cách cài đặt VibeVoice
VibeVoice là dự án dành cho những người thích khám phá AI và có chút kiến thức kỹ thuật. Bạn có thể thử trực tiếp trên trình duyệt hoặc cài đặt trên máy tính để chủ động xử lý dữ liệu.
Cách 1: Dùng thử trực tuyến, không cần cài đặt
Nếu chỉ muốn trải nghiệm trước, bạn có thể truy cập các bản demo chính thức của Microsoft.
- VibeVoice-ASR Playground – thử chuyển giọng nói thành văn bản.
- GitHub VibeVoice – xem mã nguồn, tài liệu và các bản demo.
- VibeVoice Realtime – hướng dẫn tạo giọng nói theo thời gian thực, có liên kết Google Colab.
Đây là cách phù hợp nhất cho người mới vì không cần chuẩn bị môi trường Python hay GPU riêng.
Cách 2: Cài đặt trên máy tính
Nếu muốn chạy VibeVoice trên máy cá nhân, bạn cần Git, Python, pip và môi trường hỗ trợ PyTorch. Với cấu hình GPU NVIDIA, Microsoft khuyến nghị sử dụng Docker có hỗ trợ CUDA.
Trước tiên, tải mã nguồn về máy:
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
Nếu muốn sử dụng tính năng nhận diện giọng nói, cài đặt bằng lệnh:
pip install -e .Sau đó khởi chạy giao diện Gradio:
python demo/vibevoice_asr_gradio_demo.py \
  --model_path microsoft/VibeVoice-ASR
Bạn cần cài thêm FFmpeg để xử lý âm thanh. Khi chạy thành công, ứng dụng sẽ cung cấp giao diện để tải file âm thanh và thực hiện nhận diện giọng nói. Mô hình có thể được tải về trong lần chạy đầu tiên nên sẽ cần thêm thời gian và dung lượng lưu trữ.
Nếu muốn trải nghiệm Text-to-Speech theo thời gian thực, hãy cài thêm thành phần tương ứng:
pip install -e ".[streamingtts]"Rồi chạy:
python demo/vibevoice_realtime_demo.py \
  --model_path microsoft/VibeVoice-Realtime-0.5B
Microsoft cho biết phiên bản Realtime đã được thử nghiệm trên NVIDIA T4 và Mac M4 Pro, nhưng tốc độ thực tế vẫn phụ thuộc vào cấu hình máy và môi trường cài đặt.
Hướng dẫn sử dụng VibeVoice
Để dễ hình dung, mình lấy hai tình huống thường gặp khi làm nội dung.
Chuyển podcast hoặc video thành văn bản
Giả sử bạn có một podcast dài 30 phút và muốn lấy toàn bộ nội dung để biên tập lại thành bài blog.
Sau khi mở VibeVoice-ASR, bạn tải file âm thanh lên, bắt đầu xử lý và chờ hệ thống nhận diện. Kết quả có thể bao gồm nội dung lời nói, mốc thời gian và thông tin người nói.
Nếu muốn xử lý trực tiếp bằng dòng lệnh, bạn có thể sử dụng:
python demo/vibevoice_asr_inference_from_file.py \
  --model_path microsoft/VibeVoice-ASR \
  --audio_files podcast.mp3
Bạn cũng có thể bổ sung từ khóa chuyên ngành hoặc tên riêng theo hướng dẫn của mô hình để tăng khả năng nhận diện chính xác.
Điểm đáng chú ý là VibeVoice-ASR hỗ trợ hơn 50 ngôn ngữ, trong đó có tiếng Việt. Vì vậy, đây là một lựa chọn đáng thử nếu bạn cần chuyển nội dung video hoặc bản ghi âm tiếng Việt thành văn bản. GitHub
Tạo giọng đọc AI cho nội dung kể chuyện
Với VibeVoice-Realtime, bạn có thể nhập văn bản để mô hình tạo giọng nói. Chẳng hạn, một đoạn kể chuyện:
Đêm hôm đó, Nam nhận được một cuộc gọi kỳ lạ. Trên màn hình điện thoại chỉ hiện một dòng chữ: Tôi – 10 năm sau.
Bạn có thể chuẩn bị nội dung này trong file .txt, sau đó dùng script của dự án để tạo âm thanh:
python demo/realtime_model_inference_from_file.py \
  --model_path microsoft/VibeVoice-Realtime-0.5B \
  --txt_path story.txt \
  --speaker_name Carter
Trong ví dụ này, Carter là tên giọng có sẵn được sử dụng trong tài liệu. Bạn có thể tìm hiểu thêm những giọng thử nghiệm khác từ repository.
Tuy nhiên, phiên bản Realtime hiện chủ yếu được thiết kế cho tiếng Anh và một người nói. Khả năng đọc tiếng Việt tự nhiên, thể hiện cảm xúc hoặc tạo hội thoại nhiều nhân vật chưa phải điểm mạnh được Microsoft xác nhận cho phiên bản này.
Những điểm cần lưu ý
Mặc dù rất tiềm năng, VibeVoice vẫn có một vài giới hạn mà bạn nên biết trước khi sử dụng.
Trước hết, không phải mọi mô hình VibeVoice đều có cùng chức năng. ASR dùng để nhận diện giọng nói, Realtime dùng để tạo giọng nói trực tiếp, còn TTS dài 90 phút là một nhánh nghiên cứu có mã nguồn đã bị gỡ khỏi repository chính. Vì vậy, hãy chọn đúng mô hình theo nhu cầu thay vì nghĩ rằng chỉ cần cài VibeVoice là có đầy đủ mọi tính năng.
Về tiếng Việt, VibeVoice-ASR đã có hỗ trợ và kết quả đánh giá công khai. Ngược lại, VibeVoice-Realtime vẫn ưu tiên tiếng Anh. Nếu mục tiêu của bạn là tạo giọng kể chuyện tiếng Việt giàu cảm xúc cho TikTok hoặc YouTube, nên thử chất lượng thực tế trước khi quyết định sử dụng lâu dài.
Ngoài ra, chạy mô hình AI trực tiếp trên máy có thể tiêu tốn khá nhiều RAM, VRAM và dung lượng lưu trữ. Người mới nên bắt đầu bằng bản demo hoặc Google Colab trước khi đầu tư thời gian cài đặt.
Cuối cùng là vấn đề bản quyền và sử dụng có trách nhiệm. Dù repository sử dụng giấy phép MIT, Microsoft vẫn khuyến cáo các mô hình này phục vụ nghiên cứu, chưa nên đưa thẳng vào ứng dụng thương mại khi chưa kiểm thử và phát triển thêm. Bạn cũng không nên sử dụng AI để giả giọng người khác khi chưa được phép hoặc tạo nội dung gây hiểu nhầm.
VibeVoice có đáng để trải nghiệm?
Mình nghĩ là có, đặc biệt nếu bạn quan tâm đến AI giọng nói và muốn tìm một giải pháp mã nguồn mở để tự khám phá, tùy chỉnh hoặc tích hợp vào dự án riêng.
VibeVoice-ASR khá hấp dẫn cho việc chuyển podcast, cuộc họp và video dài thành văn bản. Trong khi đó, VibeVoice-Realtime mở ra khả năng xây dựng ứng dụng có thể phản hồi bằng giọng nói gần như tức thì.
Tuy nhiên, nếu nhu cầu chính của bạn là tạo voice-over tiếng Việt thật tự nhiên, nhiều cảm xúc và sử dụng ngay cho video, VibeVoice hiện chưa hẳn là lựa chọn thay thế trực tiếp cho ElevenLabs hay MiniMax Audio.
Dù vậy, đây vẫn là một dự án đáng theo dõi. Với hướng phát triển từ nhận diện giọng nói, xử lý âm thanh dài cho đến tạo giọng nói thời gian thực, VibeVoice cho thấy AI giọng nói mã nguồn mở đang ngày càng có nhiều khả năng ứng dụng thực tế.
Tham khảo: Microsoft VibeVoice trên GitHub · Trang giới thiệu và demo chính thức
Để lại một bình luận